الحيلة السحرية التي ليست سحرًا حقًا
تكتب بضع كلمات - ربما "تنين يحلّق فوق مدينة نيون عند الغروب" - وبعد ثوانٍ، تظهر صورة لم تكن موجودة من قبل. يبدو الأمر كالسحر، أليس كذلك؟ لكن خلف هذه الحيلة التي تبدو مستحيلة تكمن تقنية ذكية بحق، وبمجرد فهم أساسياتها، ستجد أن الأمر منطقي جدًا.
إذا تساءلت يومًا كيف تنشئ مولدات الصور بالذكاء الاصطناعي صورًا من مجرد كلمات، فأنت تطرح واحدًا من أكثر الأسئلة إثارة في التكنولوجيا الحديثة. والخبر السار هو: لا تحتاج إلى شهادة في علوم الحاسوب لفهم ذلك. لنبسّط الأمر بطريقة يستطيع أي شخص متابعتها.
البداية بالصورة الكبيرة
تخيّل أنك تتعلم رسم الكلاب. على الأرجح ستنظر إلى آلاف صور الكلاب، ملاحظًا الأنماط - أربع أرجل، فراء، خطوم، ذيول، آذان مسترخية أو مدببة. بعد رؤية أمثلة كافية، ستطوّر فهمًا لما يجعل الكلب يبدو ككلب، حتى لو لم تستطع شرح كل التفاصيل بالكلمات.
تعمل مولدات الصور بالذكاء الاصطناعي وفق مبدأ مشابه بشكل مدهش، لكن على نطاق هائل وبدقة رياضية بدلًا من الحدس البشري. تتعلم من ملايين وملايين الصور، بانية فهمًا داخليًا لشكل الأشياء - القطط، الجبال، الغروب، الفن التجريدي، الصور القديمة، وكل ما بينها.
والنتيجة نظام لا ينسخ الصور الموجودة بل ينشئ بالفعل صورًا جديدة بناءً على الأنماط المتعلّمة. إنه أشبه بالفرق بين حفظ كلمات أغنية وفهم الموسيقى بما يكفي لتأليف ألحانك الخاصة.
عملية تحويل الضوضاء إلى صورة (شرح الانتشار)
هنا يصبح الأمر مثيرًا للاهتمام. تستخدم أشهر مولدات الصور بالذكاء الاصطناعي اليوم ما يُسمى "نماذج الانتشار" (diffusion models). لا تقلق - الاسم يبدو معقدًا، لكن الفكرة بسيطة جدًا بمجرد أن تراها.
تذكّر تشويش شاشة التلفاز
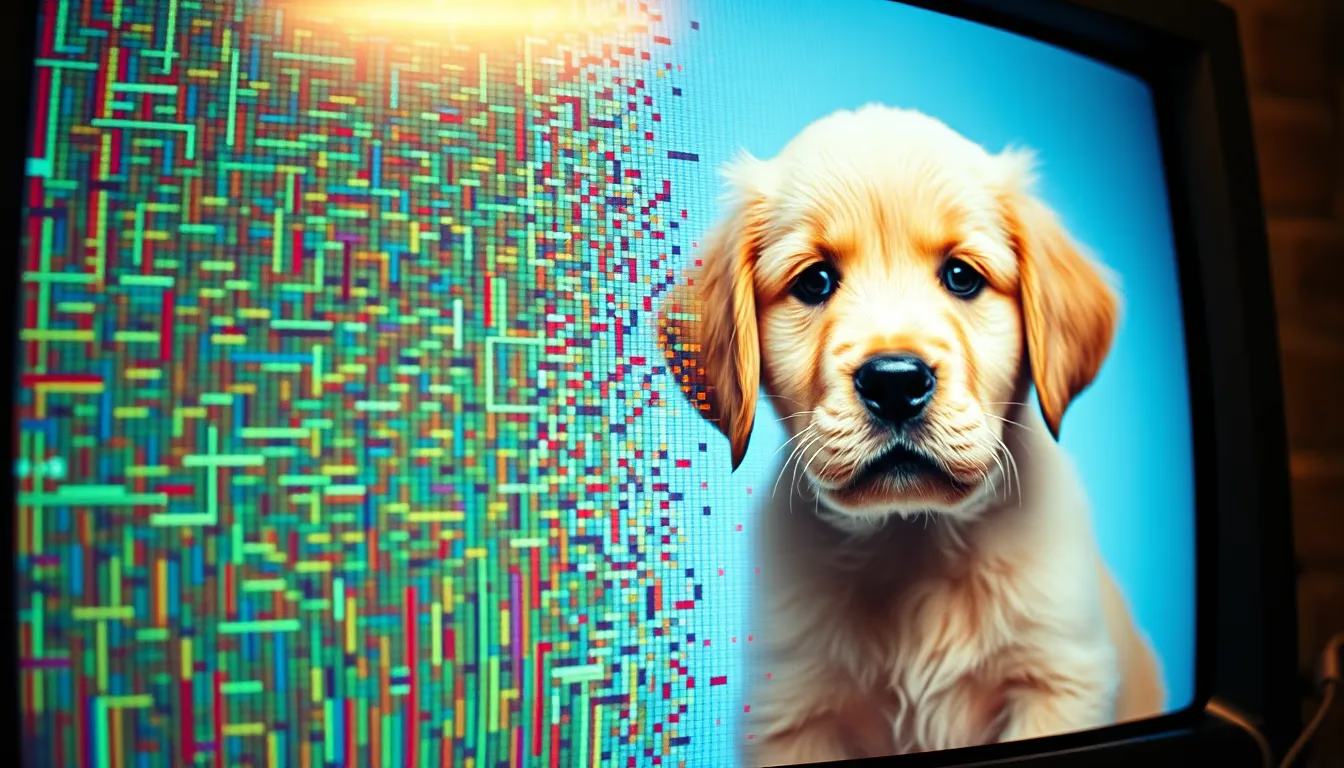
هل تتذكر أجهزة التلفاز القديمة التي كانت تعرض تشويشًا ضبابيًا عند فقدان الإشارة؟ ضوضاء عشوائية خالصة، بلا صورة على الإطلاق. تخيّل الآن لو استطعت بطريقة ما تدريب نظام على إزالة تلك الضوضاء تدريجيًا، جزءًا تلو الآخر، حتى تظهر صورة واضحة.
هذا بالضبط ما تفعله نماذج الانتشار، لكن بترتيب عكسي أثناء التدريب.
كيف يتم التدريب
أثناء التدريب، يأخذ الذكاء الاصطناعي ملايين الصور الحقيقية ويضيف إليها ضوضاء عشوائية تدريجيًا - كأنه يحوّل صورة فوتوغرافية واضحة إلى تشويش شيئًا فشيئًا. يقوم بذلك بخطوات صغيرة جدًا، متعلمًا في كل مرحلة بالضبط كم من الضوضاء أُضيفت وكيف كانت الصورة قبل ظهور تلك الضوضاء.
بعد القيام بذلك عددًا لا يُحصى من المرات مع عدد لا يُحصى من الصور، يصبح الذكاء الاصطناعي بارعًا بشكل مذهل في العملية العكسية: أخذ ضوضاء خالصة وإزالتها خطوة بخطوة حتى تتشكّل صورة متماسكة.
إنشاء صور جديدة
عندما تطلب صورة جديدة، يبدأ الذكاء الاصطناعي بضوضاء عشوائية كاملة - أشبه بلوحة من التشويش الرقمي. بعد ذلك، وبتوجيه من وصفك النصي، يزيل الضوضاء تدريجيًا بطريقة تشكّل التشويش إلى شيء يطابق كلماتك. كل خطوة تقرّب الصورة أكثر من وصفك حتى تحصل على صورة نهائية.
إنه أشبه بالنحت، لكن بدلًا من إزالة الرخام للكشف عن تمثال، يزيل الذكاء الاصطناعي العشوائية للكشف عن صورة مختبئة داخل الفوضى.
المكتبة الهائلة للتعلّم
لكي يعمل كل هذا، تحتاج مولدات الصور بالذكاء الاصطناعي إلى بيانات تدريب - ونتحدث هنا عن كمية هائلة يصعب استيعابها.
ملايين وملايين من الأمثلة
تتدرب مولدات الصور الحديثة على مجموعات بيانات تحتوي على مئات الملايين من الصور، كل واحدة مقترنة بوصف نصي. تُعلّم هذه الأزواج من الصور والنصوص الذكاء الاصطناعي كيفية ربط الكلمات بالمفاهيم البصرية. عندما تتضمن بيانات التدريب آلاف الصور الموسومة بـ"غروب فوق المحيط"، يتعلم الذكاء الاصطناعي ما هي العناصر البصرية التي تظهر عادةً في مثل هذه المشاهد - ألوان دافئة، خطوط مائية أفقية، موضع الشمس، أنماط الغيوم.
يخلق هذا التعرّض الهائل ما يمكن تسميته بالمفردات البصرية. تمامًا كما تعلّمت أن كلمة "كرسي" تشير إلى أشياء لها مقاعد وظهور، يتعلم الذكاء الاصطناعي أن كلمات معينة تقابل أنماطًا بصرية معينة.
تعلّم المفاهيم، لا نسخ الصور
والأهم من ذلك، أن مولدات الذكاء الاصطناعي المصممة جيدًا لا تقوم ببساطة بتخزين صور التدريب واسترجاعها. بل تستخلص الأنماط والعلاقات والمفاهيم. عندما تطلب "دراجة حمراء في باريس"، لا يبحث الذكاء الاصطناعي عن صورة مطابقة - بل يجمع بين فهمه المتعلّم للدراجات واللون الأحمر والجماليات الباريسية لإنشاء شيء جديد.
هذا التمييز مهم لأنه الفرق بين محرك بحث وأداة إبداعية. يولّد الذكاء الاصطناعي توليفات جديدة، وهذا هو سبب إمكانية طلب أشياء ربما لا وجود لها في أي صورة فوتوغرافية، مثل "قطة ترتدي تاجًا صغيرًا وتجلس على عرش مخملي".
كيف تتحوّل الكلمات إلى صور
الرابط بين النص والصورة هو حيث يصبح الأمر ذكيًا بشكل خاص. يحتاج طلبك النصي إلى توجيه عملية إزالة الضوضاء، موجّهًا إياها نحو النتيجة المرغوبة.
فهم كلماتك
قبل أن يتمكن الذكاء الاصطناعي من توليد الصور، يحتاج إلى فهم ما تطلبه. يحدث هذا من خلال نماذج اللغة - أنظمة ذكاء اصطناعي مدرّبة على فهم معنى النص. عندما تكتب "كوخ مريح في الخريف"، يفكك المكوّن اللغوي هذا إلى مفاهيم مفهومة: نوع الهندسة المعمارية، الأجواء، الفصل، الألوان والإضاءة المرتبطة به.
تؤثر هذه المفاهيم المفهومة بعد ذلك في كل خطوة من خطوات عملية توليد الصورة، موجّهة إزالة الضوضاء في اتجاهات تتماشى مع وصفك.
لماذا الأوامر النصية مهمة جدًا
يفسّر هذا لماذا أصبحت كتابة الأوامر النصية شكلًا من أشكال الفن بحد ذاتها. الأوامر الأكثر تفصيلًا ودقة تعطي الذكاء الاصطناعي توجيهًا أكبر، مما ينتج نتائج أقرب إلى صورتك الذهنية. الأوامر الغامضة تترك مجالًا أكبر للتفسير، وهو ما قد يكون محررًا أو محبطًا حسب أهدافك.
كما استُكشف في دليلنا حول محتوى وسائل التواصل الاجتماعي بالذكاء الاصطناعي، يساعدك فهم كيفية التواصل مع أدوات الصور بالذكاء الاصطناعي على إنشاء محتوى بصري أكثر فعالية لأي غرض. تنطبق مبادئ التواصل الواضح والوصفي سواء كنت تُنشئ محتوى لإنستغرام، أو صور مصغّرة ليوتيوب، أو مشاريع شخصية.
اللبنات الأساسية: الشبكات العصبية
خلف كل ما ناقشناه توجد الشبكات العصبية - أنظمة حاسوبية مستوحاة بشكل فضفاض من بنية الدماغ البشري.
طبقات فوق طبقات
تتكون الشبكات العصبية من طبقات مترابطة تعالج المعلومات. قد تتعرف الطبقات المبكرة على عناصر أساسية مثل الحواف والألوان. تجمع الطبقات الوسطى هذه في أشكال وملمس. تفهم الطبقات اللاحقة مفاهيم معقدة مثل الوجوه أو الحيوانات أو الأنماط المعمارية.
أثناء التدريب، تعدّل هذه الشبكات ملايين الإعدادات الداخلية (تُسمى المعاملات) لتحسين تنبؤاتها. إنه أشبه بضبط ملايين المقابض الصغيرة حتى ينتج النظام نتائج جيدة باستمرار.
لماذا استحق "التعلّم العميق" اسمه
كلمة "عميق" في التعلّم العميق تشير إلى وجود طبقات عديدة - تمتلك مولدات الصور الحديثة بنى ذات عمق وتعقيد هائلين. يتيح لها هذا العمق التقاط أنماط وعلاقات دقيقة بشكل لا يصدق كانت ستفوت الأنظمة الأبسط تمامًا.
ما تستطيع مولدات الصور بالذكاء الاصطناعي فعله وما لا تستطيع
فهم التقنية يساعد في تفسير كل من قدرات هذه الأدوات وحدودها.
قدرات مبهرة
تستطيع مولدات الصور الحديثة بالذكاء الاصطناعي إنتاج صور مفصّلة وجذابة جماليًا بشكل ملحوظ عبر أنماط لا حصر لها. تتعامل مع مفاهيم مجردة، وتجمع عناصر غير متوقعة، وغالبًا ما تنتج نتائج تفاجئ مبتكريها بحق. تجعل منصات مثل Photomize AI هذه القدرات متاحة دون الحاجة إلى خبرة تقنية.
القيود الحالية
على الرغم من قدراتها المبهرة، لا تزال مولدات الذكاء الاصطناعي تواجه صعوبة مع أمور معينة. غالبًا ما يظهر النص داخل الصور مشوّهًا. عدّ أعداد محددة من الأشياء يثبت أنه غير موثوق. العلاقات المكانية المعقدة أو الزوايا غير المعتادة يمكن أن تربك النظام. تبقى الأيدي والأصابع تحديًا معروفًا بصعوبته.
تنبع هذه القيود من عملية التدريب - إذا ظهرت مفاهيم معينة بشكل غير منتظم أو نادر في بيانات التدريب، يبقى فهم الذكاء الاصطناعي لها هشًا.
تقنيات صور ذكاء اصطناعي ذات صلة
نفس الأساليب الأساسية تشغّل أدوات متخصصة متنوعة تتجاوز التوليد المحض.
تتيح تقنيات مشابهة لتلك الموجودة في المولدات إزالة الخلفية بالذكاء الاصطناعي، حيث تتعلم الأنظمة التمييز بين الأشخاص والخلفيات بدقة مذهلة. التعرف على الأنماط الذي يساعد المولدات على فهم ما ينتمي إلى الصورة يساعد أيضًا أدوات الإزالة على فهم ما يجب فصله.
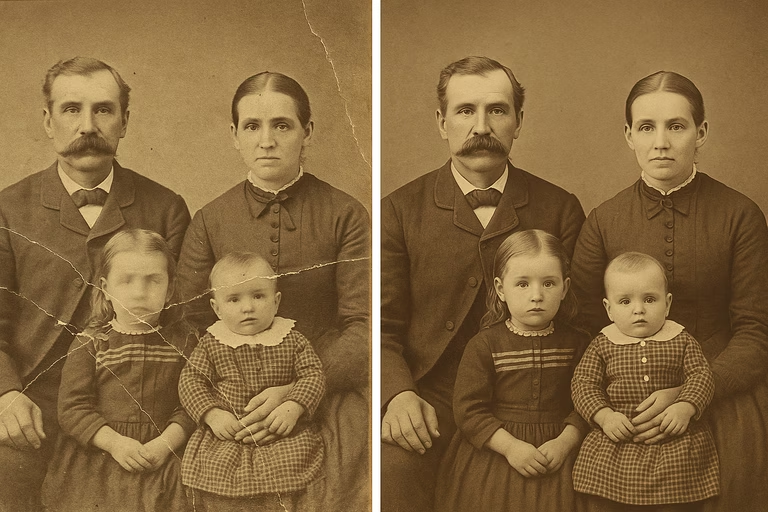
وبالمثل، تستخدم ترميم الصور بالذكاء الاصطناعي أنماطًا متعلّمة لملء الأجزاء التالفة أو المفقودة من الصور - وهي في الأساس نسخة مقيّدة من توليد الصور تركز على إكمال الصور الموجودة بدلًا من إنشاء صور جديدة تمامًا.
لماذا يهم هذا المبدعين اليوميين
فهم كيفية عمل مولدات الصور بالذكاء الاصطناعي ليس مُرضيًا فكريًا فحسب - بل يجعلك أفضل في استخدامها.
معرفة أن الذكاء الاصطناعي تعلّم من أزواج الصور والنصوص تساعدك على كتابة أوامر نصية أكثر فعالية. فهم عملية تحويل الضوضاء إلى صورة يفسّر لماذا ينتج التوليد أحيانًا نتائج غير متوقعة ولماذا يمكن أن تُنتج المحاولات المتعددة نتائج مختلفة من نفس الأمر النصي.
تساعدك هذه المعرفة أيضًا على وضع توقعات واقعية. مولدات الصور بالذكاء الاصطناعي هي أدوات إبداعية قوية بحق، لكنها ليست قارئة أفكار. تستجيب للمعلومات التي تقدّمها، مصفّاة عبر الأنماط المتعلّمة من بيانات التدريب.
التقنية مستمرة في التطور
ما وصفناه يمثّل الحالة الراهنة لتوليد الصور بالذكاء الاصطناعي في عام 2026، لكن هذا المجال يتحرك بسرعة ملحوظة. يطوّر الباحثون باستمرار بنى جديدة وأساليب تدريب وتقنيات تعالج القيود الحالية.
من المرجح أن تتعامل الأنظمة المستقبلية بشكل أفضل مع عرض النصوص، وأن تدير العلاقات المكانية المعقدة بموثوقية أكبر، وأن تنتج نتائج بجودة أعلى. من المرجح أن تبقى المبادئ الأساسية - تعلّم الأنماط من البيانات واستخدامها لتوجيه التوليد - لكن التطبيقات ستزداد تطورًا باستمرار.
في الختام: ليس سحرًا، بل تقنية رائعة حقًا
تعمل مولدات الصور بالذكاء الاصطناعي من خلال تعلّم الأنماط البصرية من مجموعات بيانات ضخمة، ثم استخدام تلك المعرفة المتعلّمة لتحويل الضوضاء العشوائية إلى صور متماسكة موجّهة بأوصاف نصية. تنطوي العملية على رياضيات متطورة وموارد حاسوبية هائلة، لكن المفاهيم الأساسية في متناول أي شخص مستعد للتفكير فيها.
في المرة القادمة التي تكتب فيها أمرًا نصيًا وتشاهد صورة تظهر، ستعرف ما يحدث تحت السطح - ليس سحرًا، بل تقنية رائعة حقًا تستمر في إعادة تشكيل كيفية إنشائنا للمحتوى البصري وتفاعلنا معه.