魔法のようで、実は魔法じゃないトリック
「夕焼けに染まるネオン都市の上を飛ぶドラゴン」といった言葉をいくつか入力すると、数秒後には今まで存在しなかった画像が現れます。まるで魔法のようですよね?でも、その一見不可能に思えるトリックの裏には、基本さえ理解すればとても納得できる、実に賢い技術が隠れています。
AI画像生成ツールがどうやって言葉だけから絵を作り出しているのか気になったことがあるなら、あなたは現代技術の中でも最も興味深い問いの一つを投げかけていることになります。そして朗報があります。それを理解するのにコンピューターサイエンスの学位は必要ありません。誰でも理解できるように、順を追って説明していきましょう。
まずは全体像から
犬の絵を描く練習をしていると想像してみてください。おそらく何千枚もの犬の写真を見て、パターンに気づくでしょう——4本の足、毛並み、鼻先、しっぽ、垂れた耳やとがった耳。十分な数の例を見た後には、すべての細部を言葉で説明できなくても、「犬らしさ」とは何かという理解が身についているはずです。
AI画像生成ツールは、驚くほど似た原理で動いています。ただし、人間の直感ではなく、桁違いの規模と数学的な精度で行われる点が違います。何百万、何千万もの画像から学習し、猫、山、夕焼け、抽象アート、ヴィンテージ写真など、あらゆるものの見た目についての内部的な理解を構築していくのです。
その結果生まれるのは、既存の画像をコピーするのではなく、学習したパターンをもとに本当に新しい画像を作り出すシステムです。それは、歌詞を丸暗記することと、音楽を理解して自分でメロディーを作曲できるようになることの違いに似ています。
ノイズから画像へのプロセス(拡散モデルを解説)
ここからが面白いところです。現在最も普及しているAI画像生成ツールは「拡散モデル(ディフュージョンモデル)」と呼ばれる仕組みを使っています。名前は複雑に聞こえますが、一度見てしまえばとてもシンプルな考え方です。
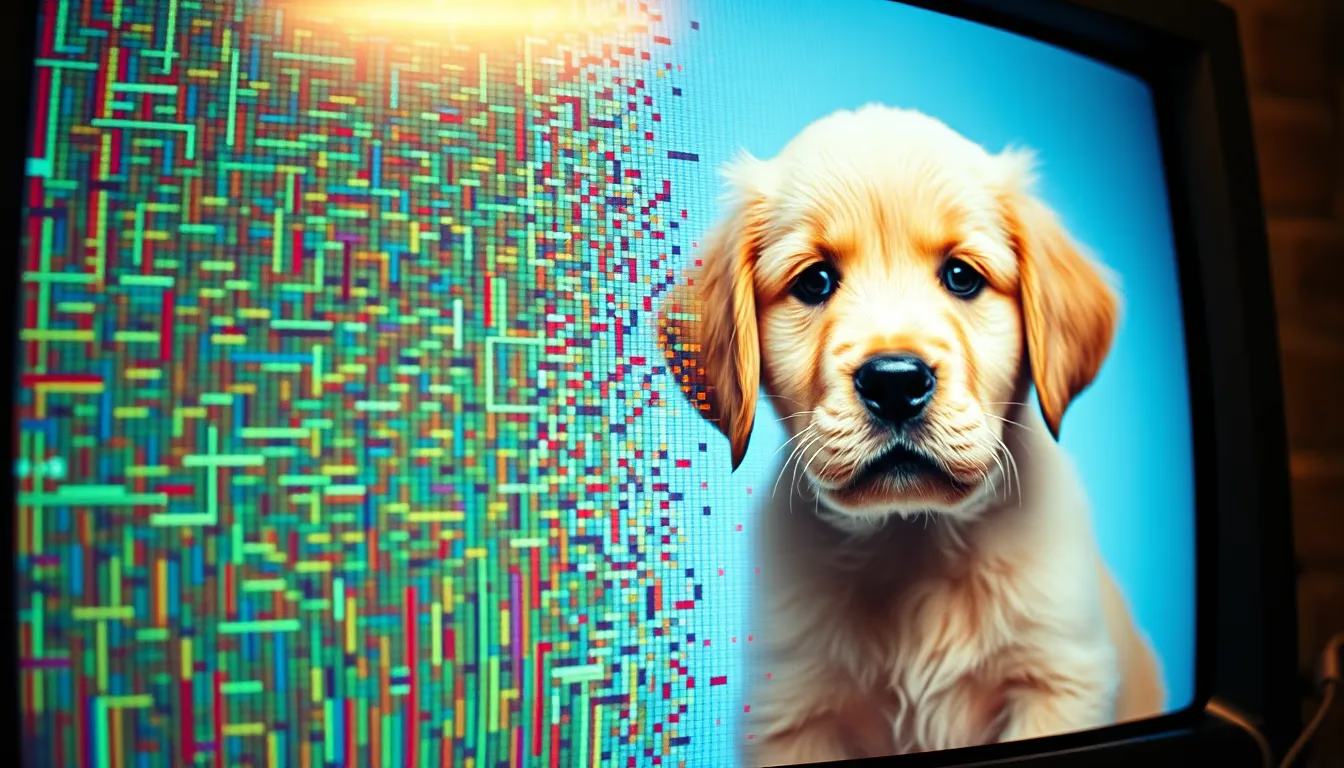
昔のテレビのノイズを思い浮かべてみよう
電波が届かないときに映る、ザラザラしたノイズ画面を覚えていますか?完全にランダムなノイズで、画像は何も映っていません。もし、そのノイズを少しずつ取り除いていくように訓練されたシステムがあり、最終的にくっきりとした画像が浮かび上がってくるとしたらどうでしょう。
それこそが拡散モデルの本質ですが、学習時には順序が逆になります。
学習の仕組み
学習の過程で、AIは何百万枚もの実在する画像を使い、そこに少しずつランダムなノイズを加えていきます——鮮明な写真を徐々にノイズ画面に変えていくようなイメージです。これを細かいステップに分けて行い、各段階でどれくらいのノイズが加えられたか、そしてノイズが加わる前の画像がどうだったかを正確に学習していきます。
これを無数の画像を使って何度も繰り返すことで、AIは逆のプロセス——純粋なノイズを受け取り、それを段階的に取り除いて一貫性のある画像を形作ること——が驚くほど上手になります。
新しい画像を作る
新しい画像をリクエストすると、AIはまず完全にランダムなノイズ、いわばデジタルなザラザラ画面から出発します。そして、あなたが入力したテキストの説明に導かれながら、ノイズを段階的に取り除き、そのザラザラを言葉に一致する何かへと形作っていきます。各ステップごとに、画像はあなたの説明に少しずつ近づいていき、最終的に完成した一枚の画像になります。
それはまるで彫刻のようですが、大理石を削って像を浮かび上がらせる代わりに、AIはランダム性を削り取って、混沌の中に隠れていた画像を浮かび上がらせているのです。
膨大な学習ライブラリ
これらすべてが機能するためには、AI画像生成ツールには学習データが必要です——それも、ほとんど理解しがたいほど膨大な量のデータです。
何百万、何千万もの事例
現代の画像生成ツールは、それぞれテキストの説明と対になった何億枚もの画像を含むデータセットで学習しています。この画像とテキストのペアが、AIに言葉と視覚的な概念を結びつけることを教えます。学習データに「海に沈む夕日」というラベルの付いた写真が何千枚も含まれていれば、AIはそうしたシーンに典型的に現れる視覚的要素——暖色系の色合い、水平な水平線、太陽の位置、雲のパターン——を学習します。
この膨大な経験によって、いわば「視覚的な語彙」が生まれます。あなたが「椅子」という言葉が座面と背もたれのあるものを指すと学んだのと同じように、AIも特定の言葉が特定の視覚パターンに対応することを学習するのです。
画像をコピーするのではなく、概念を学ぶ
重要なのは、よく設計されたAI生成ツールは、学習用画像を単に保存して取り出しているわけではないという点です。パターン、関係性、概念を抽出しているのです。「パリの赤い自転車」をリクエストしたとき、AIは一致する写真を検索しているのではありません。自転車についての学習した理解、赤という色、パリらしい美意識を組み合わせて、新しいものを生成しているのです。
この違いは重要です。それは検索エンジンと創造的なツールの違いだからです。AIは新しい組み合わせを生み出します。だからこそ、「ベルベットの玉座に座り、小さな王冠をかぶった猫」のような、おそらくどんな写真にも存在しないものをリクエストできるのです。
言葉が画像になる仕組み
テキストと画像をつなぐ部分は、特に巧妙な工夫が凝らされているところです。入力したプロンプトは、ノイズ除去のプロセスを導き、望む結果へと誘導する必要があります。
あなたの言葉を理解する
AIが画像を生成する前に、まずあなたが何を求めているのかを理解する必要があります。これは言語モデル——テキストの意味を理解するように訓練されたAIシステム——によって行われます。「秋のこぢんまりしたコテージ」と入力すると、言語コンポーネントはこれを理解可能な概念に分解します。建築のタイプ、雰囲気、季節、それに関連する色や光の具合などです。
こうして理解された概念が、画像生成プロセスの各ステップに影響を与え、ノイズ除去をあなたの説明に沿った方向へと導いていきます。
プロンプトがこれほど重要な理由
これが、プロンプトの書き方がほとんど一つの技芸(アート)になっている理由を説明しています。より詳細で具体的なプロンプトはAIにより多くの手がかりを与え、頭の中でイメージしているものに近い結果を生み出します。曖昧なプロンプトは解釈の余地を大きく残します。これは目的によって、自由度が高いと感じることもあれば、もどかしく感じることもあるでしょう。
AIによるSNS向けコンテンツについてのガイドでも触れているように、AI画像ツールとのコミュニケーションの仕方を理解することは、あらゆる目的に対してより効果的なビジュアルを作る助けになります。明確で説明的なコミュニケーションの原則は、Instagram向けのコンテンツを生成する場合でも、YouTubeのサムネイルでも、個人的なプロジェクトでも同様に当てはまります。
構成要素:ニューラルネットワーク
ここまで説明してきたことすべての土台にあるのが、人間の脳の構造に緩くヒントを得たコンピューターシステム、ニューラルネットワークです。
幾重にも重なる層
ニューラルネットワークは、情報を処理する相互接続された層で構成されています。初期の層はエッジや色といった基本的な要素を認識するかもしれません。中間の層はそれらを組み合わせて形やテクスチャにします。後段の層は、顔、動物、建築様式といった複雑な概念を理解します。
学習の過程で、これらのネットワークは予測を改善するために、何百万もの内部設定(パラメータと呼ばれます)を調整します。それはまるで、システムが一貫して良い結果を出すようになるまで、何百万もの小さなつまみを調整し続けるようなものです。
「ディープラーニング」という名前の由来
ディープラーニングの「ディープ(深い)」とは、層が多いことを指します。現代の画像生成ツールは、非常に深く複雑なアーキテクチャを持っています。この深さのおかげで、よりシンプルなシステムでは完全に見逃してしまうような、驚くほど微妙なパターンや関係性を捉えることができるのです。
AI画像生成ツールにできること、できないこと
この技術を理解することで、こうしたツールの能力と限界の両方が見えてきます。
驚くべき能力
現代のAI画像生成ツールは、無数のスタイルにわたって、非常に詳細で美的に優れた画像を生み出すことができます。抽象的な概念を扱い、ありえない要素同士を組み合わせ、作り手自身を本当に驚かせるような結果を生み出すこともよくあります。Photomize AIのようなプラットフォームは、専門的な知識を必要とせずに、こうした能力を誰でも使えるようにしています。
現在の限界
その印象的な能力にもかかわらず、AI生成ツールはいまだに特定のことを苦手としています。画像内のテキストはしばしば崩れて表示されます。物の個数を正確に数えることは信頼性に欠けます。複雑な空間的関係や見慣れない視点は、システムを混乱させることがあります。手や指は今なお非常に扱いにくい部分です。
こうした限界は学習プロセスに由来しています。ある概念が学習データの中で一貫していなかったり、稀にしか登場しなかったりすると、AIのその概念に対する理解も不安定なままになるのです。
関連するAI画像技術
同じ基本的なアプローチは、純粋な画像生成を超えた、さまざまな専門ツールを支えています。
生成ツールに用いられているものと似た技術は、AI背景除去を可能にしています。ここではシステムが被写体と背景を驚くほど正確に区別することを学習します。生成ツールが画像に何が含まれるべきかを理解する助けとなるパターン認識は、除去ツールが何を切り分けるべきかを理解する助けにもなっているのです。
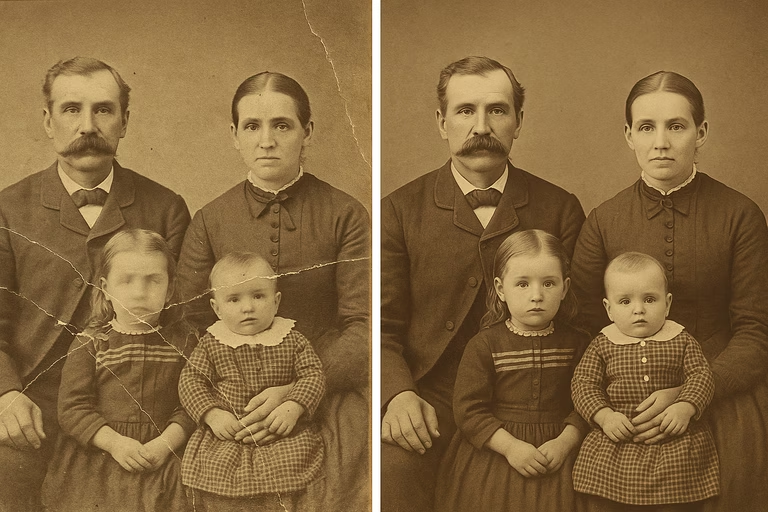
同様に、AI写真修復は、学習したパターンを使って写真の損傷部分や欠落部分を補います——これは本質的に、まったく新しい画像を作るのではなく、既存の画像を完成させることに特化した、画像生成の制約付きバージョンと言えます。
これが日常のクリエイターにとってなぜ重要なのか
AI画像生成ツールの仕組みを理解することは、知的好奇心を満たすだけではありません。それによって、あなた自身がツールをより上手に使えるようになるのです。
AIが画像とテキストのペアから学習したことを知っていれば、より効果的なプロンプトを書く助けになります。ノイズから画像への変換プロセスを理解していれば、生成が時に予想外の結果を生むことや、同じプロンプトでも複数回試すと異なる結果が出る理由が納得できるでしょう。
この知識はまた、現実的な期待値を持つことにも役立ちます。AI画像生成ツールは本当に強力な創造的ツールですが、心を読んでくれるわけではありません。学習データから得たパターンというフィルターを通して、あなたが与えた情報に応答しているのです。
進化し続ける技術
ここまで説明してきたのは、2026年時点でのAI画像生成の現状ですが、この分野は驚くほどのスピードで進歩し続けています。研究者たちは、現在の限界に対応する新しいアーキテクチャ、学習方法、技術を絶えず開発しています。
将来のシステムは、テキストのレンダリングをより上手に扱い、複雑な空間的関係をより確実に管理し、さらに高品質な結果を生み出すようになるでしょう。データからパターンを学習し、それを使って生成を導くという基本原理はおそらく変わらないままでしょうが、その実装はますます洗練されていくはずです。
まとめ:魔法ではないけれど、確かに驚くべきもの
AI画像生成ツールは、膨大なデータセットから視覚的なパターンを学習し、その学習した知識を使って、テキストの説明に導かれながらランダムなノイズを一貫性のある画像へと変換することで機能しています。このプロセスには高度な数学と膨大な計算資源が関わっていますが、その核となる考え方は、じっくり考えようとする気持ちさえあれば誰にでも理解できるものです。
次にプロンプトを入力して画像が現れるのを見るとき、あなたはその裏側で何が起きているのかを知っているはずです——それは魔法ではなく、私たちが視覚的なコンテンツを作り、関わる方法を今もなお作り変え続けている、確かに驚くべき技術なのです。