這個魔術其實不是魔術
你輸入幾個字——或許是「一隻龍在夕陽下飛過霓虹燈城市」——幾秒鐘後,一張從未存在過的圖片就出現了。感覺像魔法,對吧?但在這看似不可能的把戲背後,其實隱藏著一些真正聰明的技術,一旦你理解了基本原理,就會發現這一切都很合理。
如果你曾好奇 AI 圖像生成器究竟是如何僅憑文字就創造出圖片的,那麼你正在探索現代科技中最令人著迷的問題之一。好消息是:你不需要電腦科學學位就能理解它。讓我們用任何人都能理解的方式來拆解它。
先看整體概念
想像你正在學習畫狗。你大概會看數千張狗的照片,注意到一些規律——四條腿、毛髮、口鼻、尾巴、垂耳或豎耳。看過足夠多的範例後,你就會建立起「狗看起來像什麼」的理解,即使你無法用言語解釋每一個細節。
AI 圖像生成器的運作原理與此驚人地相似,只是規模龐大得多,而且用的是數學精確度而非人類直覺。它們從數以百萬計的圖像中學習,建立起對事物外觀的內部理解——貓、山脈、日落、抽象藝術、復古照片,以及介於其間的一切。
結果就是一個不會複製既有圖像、而是真正根據學習到的規律創造出全新圖像的系統。這就像是死記歌詞和真正理解音樂到足以譜出自己旋律之間的差異。
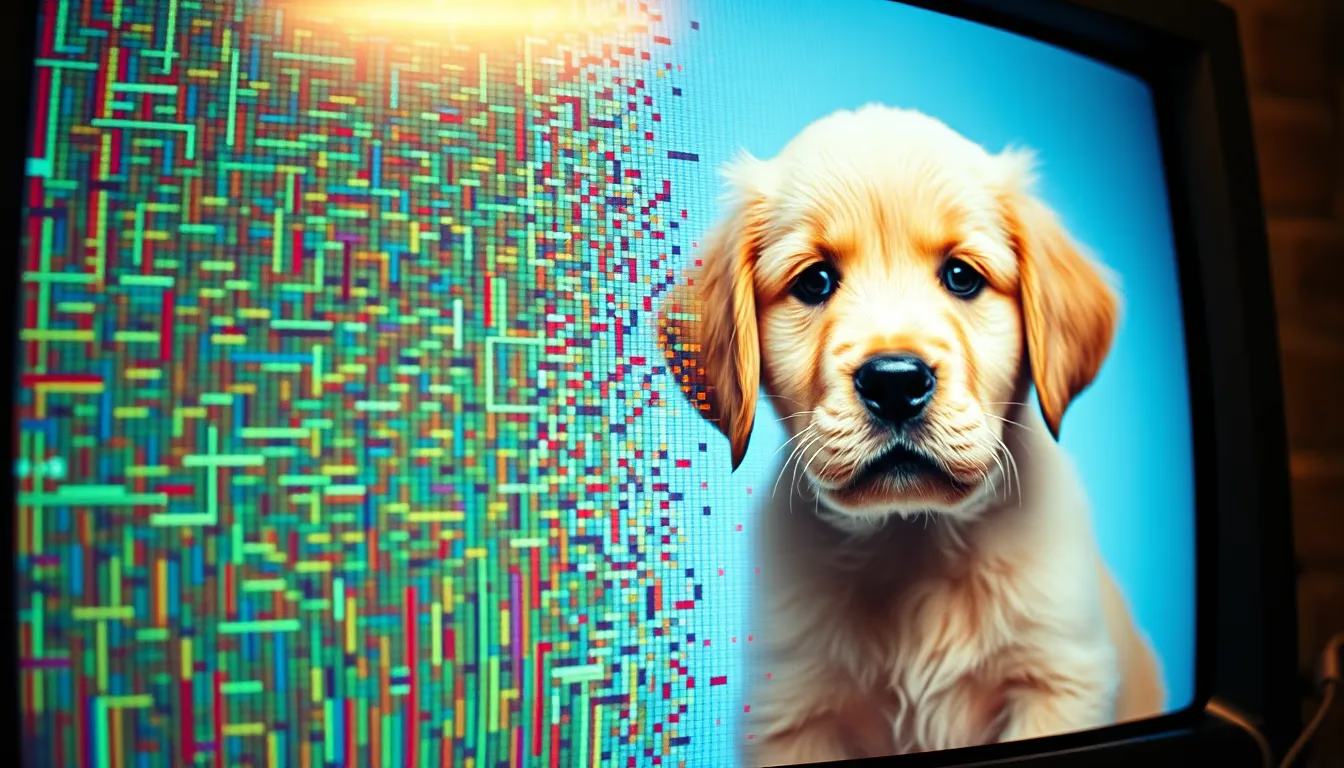
從噪點到圖片的過程(擴散模型解說)
這裡就是有趣的地方了。當今最受歡迎的 AI 圖像生成器使用一種叫做「擴散模型」的技術。別擔心——這個名字聽起來很複雜,但一旦你了解概念,其實非常簡單優美。
想想電視雜訊
還記得舊式電視機在訊號中斷時出現的模糊雜訊畫面嗎?純粹的隨機噪點,完全沒有圖像。現在想像,如果你能訓練一個系統,逐步、一點一滴地去除那些噪點,直到一張清晰的圖片浮現出來。
這基本上就是擴散模型在做的事,但在訓練過程中順序是相反的。
訓練是如何運作的
在訓練過程中,AI 會拿數百萬張真實圖像,慢慢地為它們加入隨機噪點——就像逐漸把一張清晰的照片變成雜訊畫面。它是以極小的步驟進行的,在每個階段都學習到底加了多少噪點,以及在噪點出現之前圖像原本的樣子。
在對無數張圖像進行無數次這樣的操作後,AI 變得非常擅長逆向過程:拿一團純粹的噪點,一步一步地去除它,直到形成一張連貫的圖像。
創造新圖像
當你要求生成一張新圖像時,AI 會從完全隨機的噪點開始——基本上是一張數位雜訊的畫布。接著,在你的文字描述引導下,它會逐步去除噪點,以符合你文字內容的方式塑造這些雜訊。每一個步驟都讓圖像更接近你的描述,直到完成一張圖片。
這就像雕刻一樣,但 AI 不是去除大理石來顯露出雕像,而是去除隨機性來顯露出隱藏在混亂中的圖像。
龐大的學習資料庫
要讓這一切運作起來,AI 圖像生成器需要訓練資料——而我們談論的是一個幾乎難以想像的龐大數量。
數以百萬計的範例
現代圖像生成器在包含數億張圖像的資料集上進行訓練,每張圖像都搭配著文字描述。這些圖文配對教導 AI 將文字與視覺概念連結起來。當訓練資料包含數千張標記為「海上日落」的照片時,AI 就會學到這類場景中通常會出現哪些視覺元素——暖色調、水平的海平面、太陽的位置、雲朵的形態。
這種大量的接觸創造出你可以稱之為「視覺詞彙」的東西。就像你學到「椅子」這個詞指的是有座位和椅背的東西一樣,AI 也學到某些詞語對應著某些視覺模式。
學習概念,而非複製圖像
至關重要的是,設計良好的 AI 生成器並不是單純地儲存和檢索訓練圖像。它們萃取的是規律、關係和概念。當你要求「巴黎的一輛紅色腳踏車」時,AI 並不是在搜尋一張相符的照片——而是結合它對腳踏車、紅色以及巴黎美學所學到的理解,生成出全新的東西。
這個區別很重要,因為這正是搜尋引擎和創作工具之間的差異。AI 生成的是全新的組合,這也是為什麼你可以要求一些可能在任何照片中都不存在的東西,比如「一隻戴著小皇冠坐在絲絨王座上的貓」。
文字如何變成圖片
文字轉圖像的連結,正是事情變得特別巧妙的地方。你輸入的提示詞需要引導去噪過程,將其導向你想要的結果。
理解你的文字
在 AI 能夠生成圖像之前,它需要先理解你在要求什麼。這是透過語言模型來實現的——經過訓練能理解文字意義的 AI 系統。當你輸入「秋天裡一間溫馨的小屋」時,語言元件會將這句話拆解成可理解的概念:建築類型、氛圍、季節、相關的色彩與光線。
這些被理解的概念接著會影響圖像生成過程的每一個步驟,將去噪的方向引導至符合你描述的方向。
為什麼提示詞如此重要
這也解釋了為什麼撰寫提示詞幾乎已經成為一門藝術。更詳細、更具體的提示詞能給 AI 更多引導,產生更接近你腦海中畫面的結果。模糊的提示詞則留下更多詮釋空間,這可能是自由發揮,也可能是令人沮喪的,取決於你的目標。
正如我們在 AI 社群媒體內容 指南中探討的那樣,理解如何與 AI 圖像工具溝通,能幫助你為任何用途創作出更有效的視覺內容。無論你是為 Instagram、YouTube 縮圖還是個人專案生成內容,清晰、具描述性的溝通原則都同樣適用。
基本建構模組:神經網路
在我們討論的一切之下,都是神經網路——一種鬆散地受人腦結構啟發的電腦系統。
一層又一層
神經網路由相互連接的層組成,用來處理資訊。早期的層可能會識別基本元素,如邊緣和顏色。中間的層則將這些組合成形狀和紋理。後期的層則理解複雜的概念,如臉孔、動物或建築風格。
在訓練過程中,這些網路會調整數百萬個內部設定(稱為參數)以改善其預測結果。這就像是調整數百萬個微小的旋鈕,直到系統能持續產生良好的結果。
「深度學習」名稱由來
深度學習中的「深度」指的是擁有許多層——現代圖像生成器的架構具有極大的深度和複雜性。這種深度讓它們能夠捕捉到更簡單系統會完全遺漏的極其細微的規律和關係。
AI 圖像生成器能做什麼,不能做什麼
了解這項技術有助於解釋這些工具的能力與限制。
令人印象深刻的能力
現代 AI 圖像生成器能在無數種風格中產生極為精細、美觀的圖像。它們能處理抽象概念、組合不太可能出現在一起的元素,而且經常產生連創造者自己都感到驚訝的結果。像 Photomize AI 這樣的平台,讓這些能力變得人人都能使用,不需要任何技術專業知識。
目前的限制
儘管有這些令人印象深刻的能力,AI 生成器在某些方面仍然力有未逮。圖像中的文字經常顯得雜亂難辨。計算特定數量的物件也不太可靠。複雜的空間關係或不尋常的視角可能會讓系統感到困惑。手部和手指仍然是出了名的難題。
這些限制源自於訓練過程——如果某些概念在訓練資料中出現得不一致或很少見,AI 對它們的理解就會顯得比較不穩固。
相關的 AI 圖像技術
同樣的基本方法也驅動著純生成以外的各種專門工具。
與生成器類似的技術也應用在 AI 去背 上,系統學會以驚人的精確度區分主體與背景。幫助生成器理解圖像中應該包含什麼的模式識別能力,同樣也幫助去背工具理解該分離出什麼。
同樣地,AI 照片修復 使用學習到的規律來填補照片中受損或缺失的部分——本質上是圖像生成的一種受限版本,專注於補完現有的圖像,而不是創造全新的圖像。
為什麼這對日常創作者很重要
了解 AI 圖像生成器的運作原理不僅僅是滿足知識上的好奇心——它能讓你更善於使用它們。
知道 AI 是從圖文配對中學習的,有助於你寫出更有效的提示詞。理解從噪點到圖像的過程,能解釋為什麼生成結果有時會出乎意料,以及為什麼相同的提示詞多次嘗試會產生不同的結果。
這些知識也能幫助你建立切合實際的期望。AI 圖像生成器確實是強大的創作工具,但它們不是讀心術士。它們會根據你提供的資訊做出回應,並透過從訓練資料中學到的規律進行過濾。
技術持續演進中
我們所描述的內容代表了 2026 年 AI 圖像生成技術的現況,但這個領域發展的速度相當驚人。研究人員不斷開發新的架構、訓練方法和技術,來解決目前的限制。
未來的系統很可能會更妥善地處理文字渲染,更可靠地管理複雜的空間關係,並產生品質更高的結果。從資料中學習規律、並用它來引導生成的基本原則,很可能會保留下來,但實作方式將會變得越來越精密複雜。
總結:不是魔法,但確實非凡
AI 圖像生成器的運作方式,是從龐大的資料集中學習視覺規律,然後運用這些學到的知識,在文字描述的引導下,將隨機噪點轉化為連貫的圖像。這個過程涉及複雜的數學和龐大的運算資源,但核心概念是任何願意花時間思考的人都能理解的。
下次當你輸入一段提示詞、看著一張圖像出現時,你就會知道表面之下正在發生什麼——不是魔法,而是持續重塑我們創作與互動視覺內容方式的真正非凡技術。